
从个人终端到团队频道:我们用 agent 的这半年
不到十人的团队,半年内从编辑器补全到三十来个 agent 承担常设任务:集群巡检、代码评审、发布、上游维护和客服,以及配套的权限和 context 共享。

这几个月,AI 让我们团队的工作方式发生了翻天覆地的变化。在 agent 的帮助下,很多事情真正做到了自动化:每天的集群巡检和告警分析、PR 评审、上游 fork 的维护、release 说明、客户群里的答疑。我们是一个不到十人的工程团队。
一年前
一年前,"用 AI"就是用带 AI 的编辑器:补全、改函数、解释不熟的代码。每个人都在用,但团队的工作方式一点没变:产出还是某个人本地的一个 diff,对话别人看不到,也没什么可看的。
那时候我们没有围绕它搭任何东西,模型还不到能把一件事交给它然后走开的程度。
转折是 Claude Opus 4.6。这是我们用到的第一个值得围绕它搭东西的模型:给它一个任务,它跑命令、读结果、接着做。几周之内 Claude Code 和 Codex 成了每个人的日常工具。
然后大家开始给它派代码以外的活。线上报错,先让 agent 看一遍。上游发了新版,让 agent 升级我们的 fork。每天早上巡一遍集群。接客户的问题。一个月之内,每个人手里都攒了一堆自己的东西:shell 脚本、cron、放在 dotfile 里的 bot token、一段拼 context 的 prompt。
两个问题
一是重复。我们把各自写的东西拿出来对了一下,基本一样:消息怎么收发、怎么定时、凭据放哪、context 怎么拼。每个人都做了一遍,都只能在自己机器上跑。
二是 context 丢了。一次会话里最有用的往往不是最后那个 diff,是中间的过程:试过什么、哪里失败、为什么选这个修法、答案在哪个 dashboard 上。这些全在一个人的终端里,会话结束就没了。别人要用,只能开会问。
先试了两周 Slack bot
六月我们试了最直接的办法:用开源的 OpenACP 搭了一群 Slack bot,改成在现有频道里一个线程对应一个会话。
有人在事故线程里 @ 一个 agent,其他人能看到它在查什么,在同一个线程里接着问。工程以外的同事也开始用,在 Slack 里 @ 一下就行。
然后就是两周打补丁,补的全是线程的事:中途 @ 要带上前面的内容,断档要回填,几个 bot 互相触发死循环。它没有"一个对话里有几个人和几个 bot"这个概念,我们在往上硬加。
- 一个平台 app 后面挂多个 agent,而不是一个 bot 一个进程、一个 Slack app、一套 token
- 多用户各自的身份,而不是一台机器共用一份登录
- 一个真正的 control plane,而不是一个在聊天里 shell 出去运维的 bot
- 带版本、可控升级的 daemon
- 重启不丢的会话;每个会话自己的 workspace,而不是所有线程共用一个目录
- 对话和线程是核心概念,不是 adapter 补丁
也试过整个换成 Hermes。它的演示覆盖了我们想要的大部分能力:循环、主动发消息、kanban、memory 都是现成的。我们把一个做 rebase 的 bot 搬过去跑了一天。最大的问题是它没有团队这一层:谁能用哪个 agent、谁能看它的会话、agent 能碰哪些仓库和工具,都没有权限模型,整套东西默认一个人用。其次是它自带的 harness 和 Claude Code 在一个任务里混着跑;没有 coding agent 的缓存和 resume,每轮把完整 context 重发一遍,延迟和成本都高;出了错分不清是哪一层。这里说的是我们当时试用的版本,Hermes 后来已经变了不少。
有两条从那时候定下来没变过:权限是平台的一部分,不是以后再加的功能;保留工程师本地在用的 harness,频道里看到的行为要能在终端里复现。
连接这层我们自己做,基于 ACP,一个月后开源,就是 AgentConnect。
现在 agent 在干什么
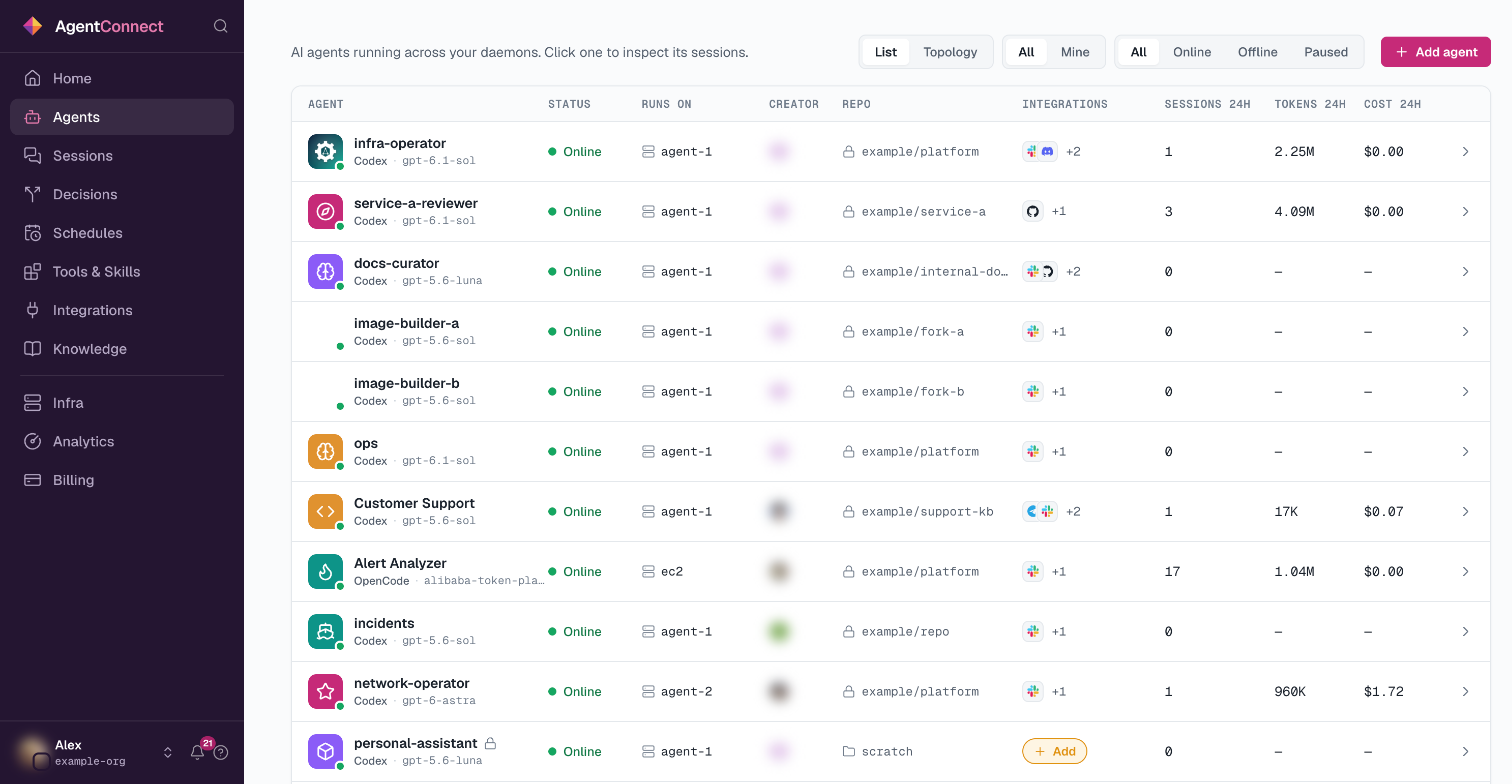
生产环境的组织是七月一个周日建的,周二已经有六个 agent 在跑,就是之前各人脚本里那些活,每个有了名字、频道和机器。现在的情况:
- 30 来个 agent:一个 generalist,其余是 specialist
- 跑在我们自己的 7 台机器和一个托管池上
- 接了 Slack、Telegram、Discord、Linear
- 20 多个定时任务
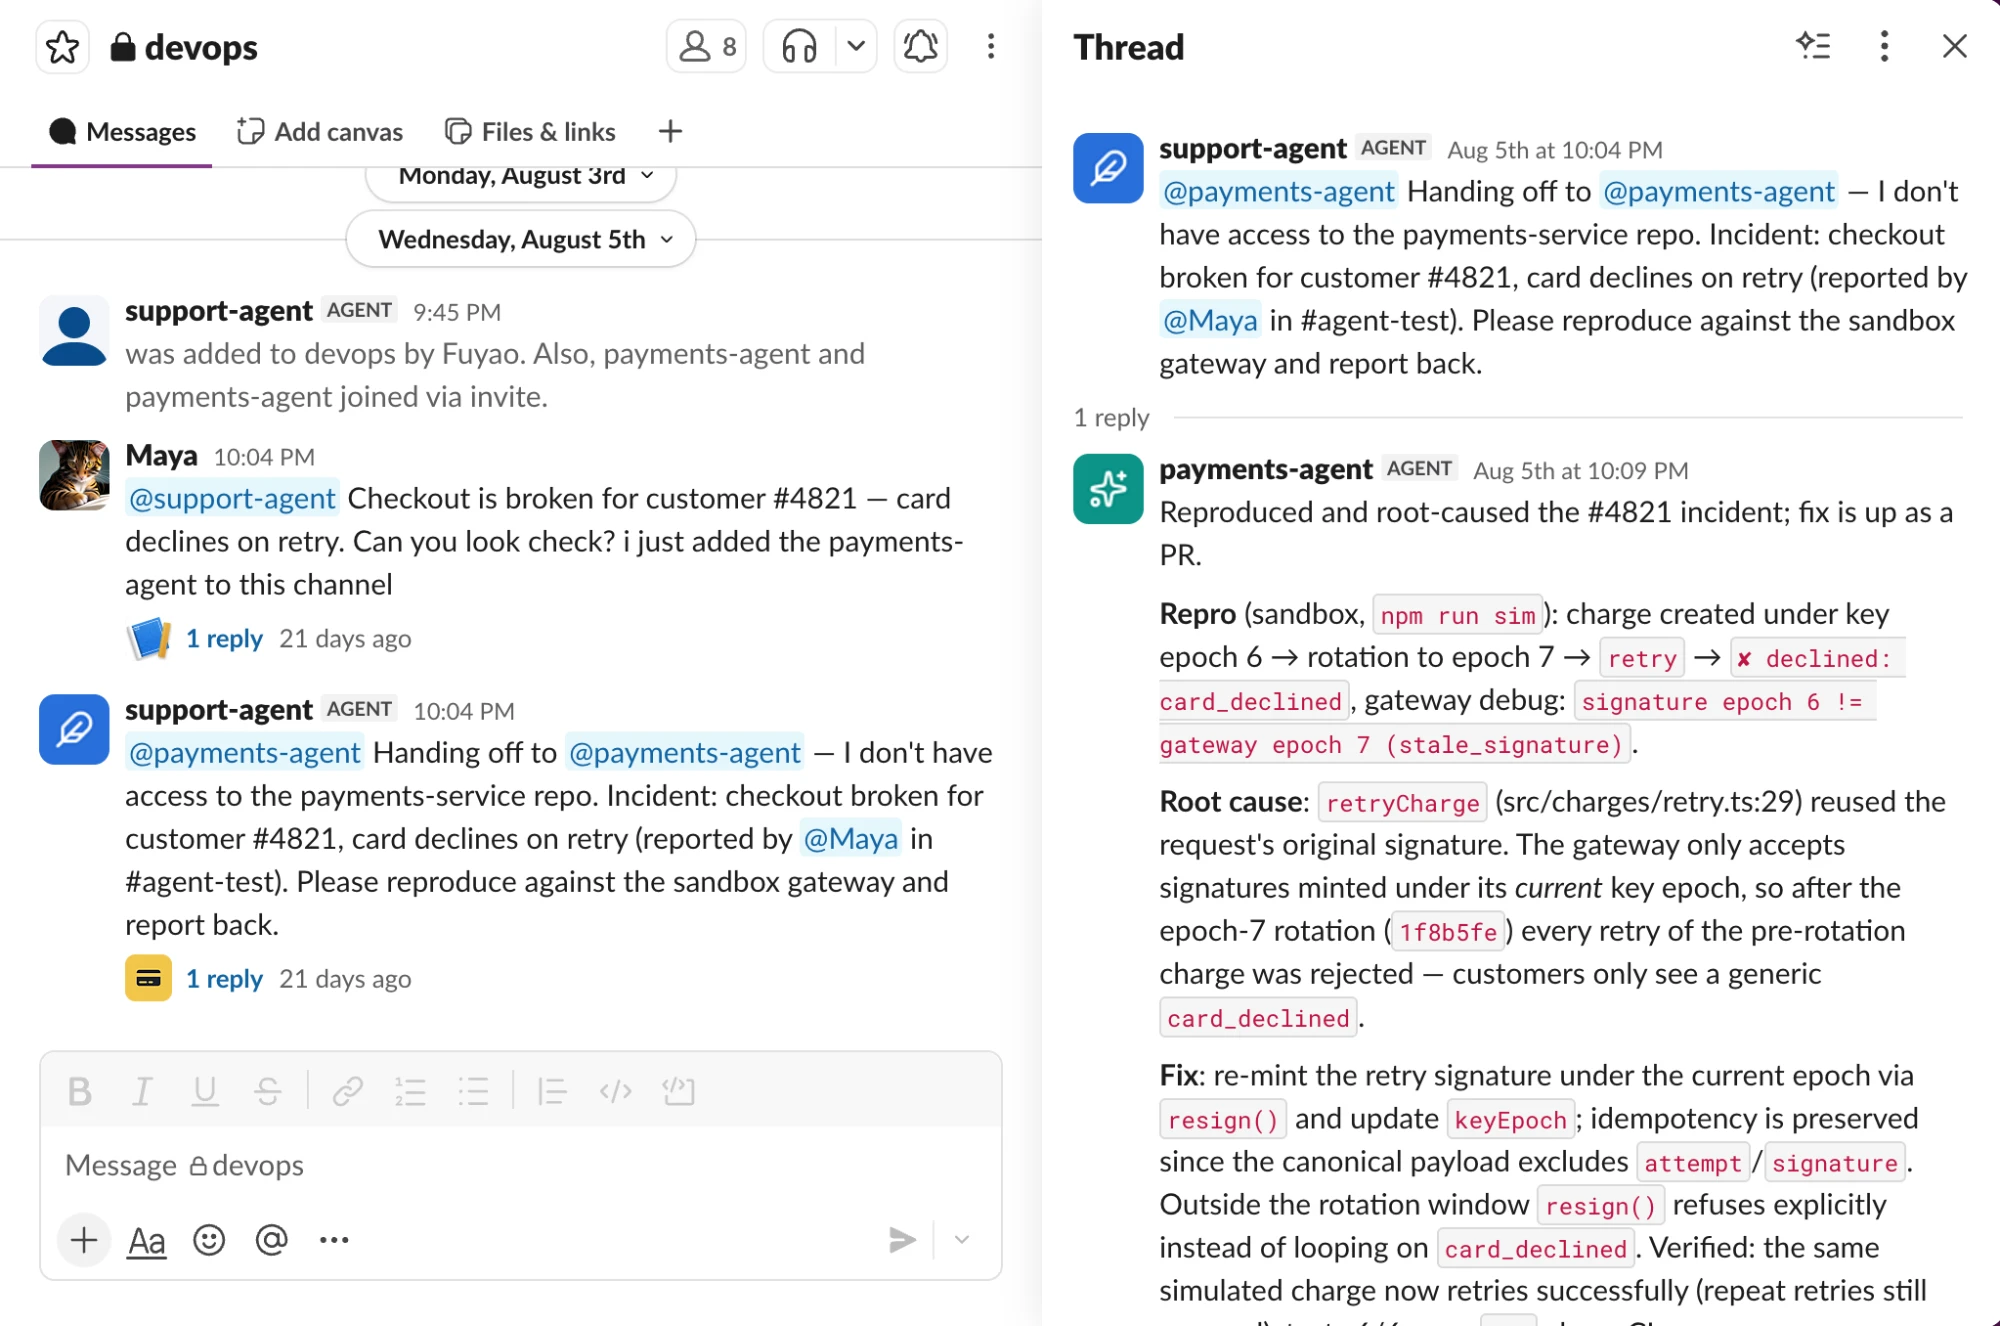
generalist 接在开发频道、私信和 Linear 上,能按需检出团队的仓库,谁有事都可以 @ 它。小改动直接在 Slack 线程里让它做:描述问题,它改代码、开 PR、跑检查,人在线程里看一眼就合并,不用打开终端。
specialist 各管一类事,有自己的仓库、工具、频道和定时任务,权限按这类事给。
设计文档和会议。 一个 agent 专管文档。设计讨论在开发频道里 @ 它,它读现有系统和已有的设计文档给方案,同事在线程里加约束,它再改;讨论定了,它开一个 PR,把结论写进 docs/ 里对应的设计文档,和实现一起评审。会议全部转录,不用转录服务自带的摘要,原始稿进一个单独的仓库,它在那里写摘要,再去更新别的仓库里相关的 issue 和设计文档。
文档库按项目分目录,每个项目下面是设计稿和会议两块:
agentconnect/
├── design-docs/                                   # reviewed as PRs
│   ├── agents-collaboration-design.md
│   └── daemon-centric-architecture.md
└── meetings/                                      # one pair per meeting
    ├── 2026-06-12-agents-collaboration-kickoff.txt          # raw transcript
    └── 2026-06-12-agents-collaboration-kickoff-summary.md   # written by the agent
巡检和告警。 一个 agent 每天早上把集群走一遍,报告发到告警频道。另有几个按业务线各盯一类服务的延迟和版本。告警进频道,值班 agent 在同一个线程里接手,查 Grafana 指标,看 Pod 和日志,对照仓库最近的变更。Kubernetes 和 Grafana 是 MCP 服务,组织里注册一次,按 agent 启用。每类事件怎么处理写成 skill 放仓库里:先看哪些指标、常见原因、什么情况自己处理、什么情况找人。处理方式变了改 skill,所有值班 agent 下次就用新的。是不是事故,工程师判断。
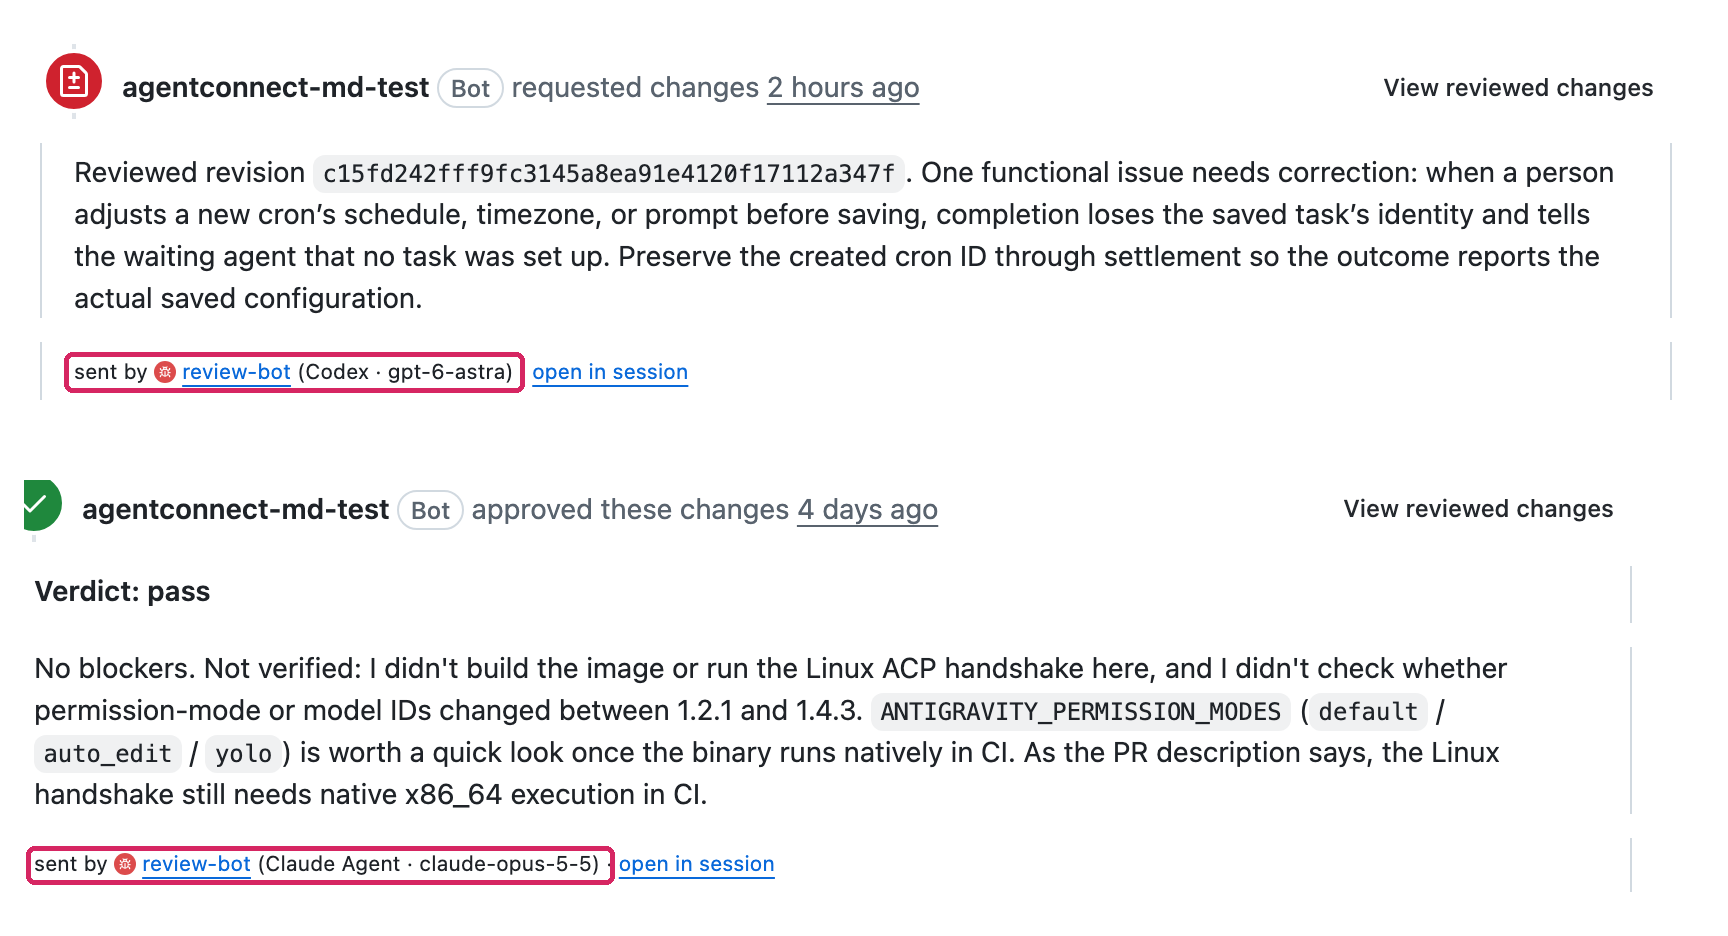
跨模型代码评审。 每个 PR 先由 review-bot 过一遍,留行内评论,给自己的 check。同一个 review-bot 可以按 PR 换 runtime 和模型,不同模型看问题的角度不一样。用 Codex 的时候,它在一个 PR 里复现了一个 bug:保存前改定时任务的时间会丢掉已保存任务的身份,要求修改,修完复审通过。用 Claude 的时候,在另一个 PR 上判定通过,列出了哪些没验证、要等 CI。要看得更深,再 @ 一个用更强模型的评审者。
发布。 每次合并进主干都出一个候选版本,发稳定版时把 release 分支指到选定的提交。发布之后的事交给 agent:核对发布成功,读两个稳定版之间的 PR,把相关的 PR 归并成一条功能来写,行为变更和升级注意单独标出,写成 release 页顶部的 Summary,再把已经完整修复的 issue 逐个评论并关闭。v2.8.0 的 Summary 就是这么来的,下面的 Features 列表是自动生成的变更记录。这套写成一个 skill,换哪个 agent 跑规则都一样。
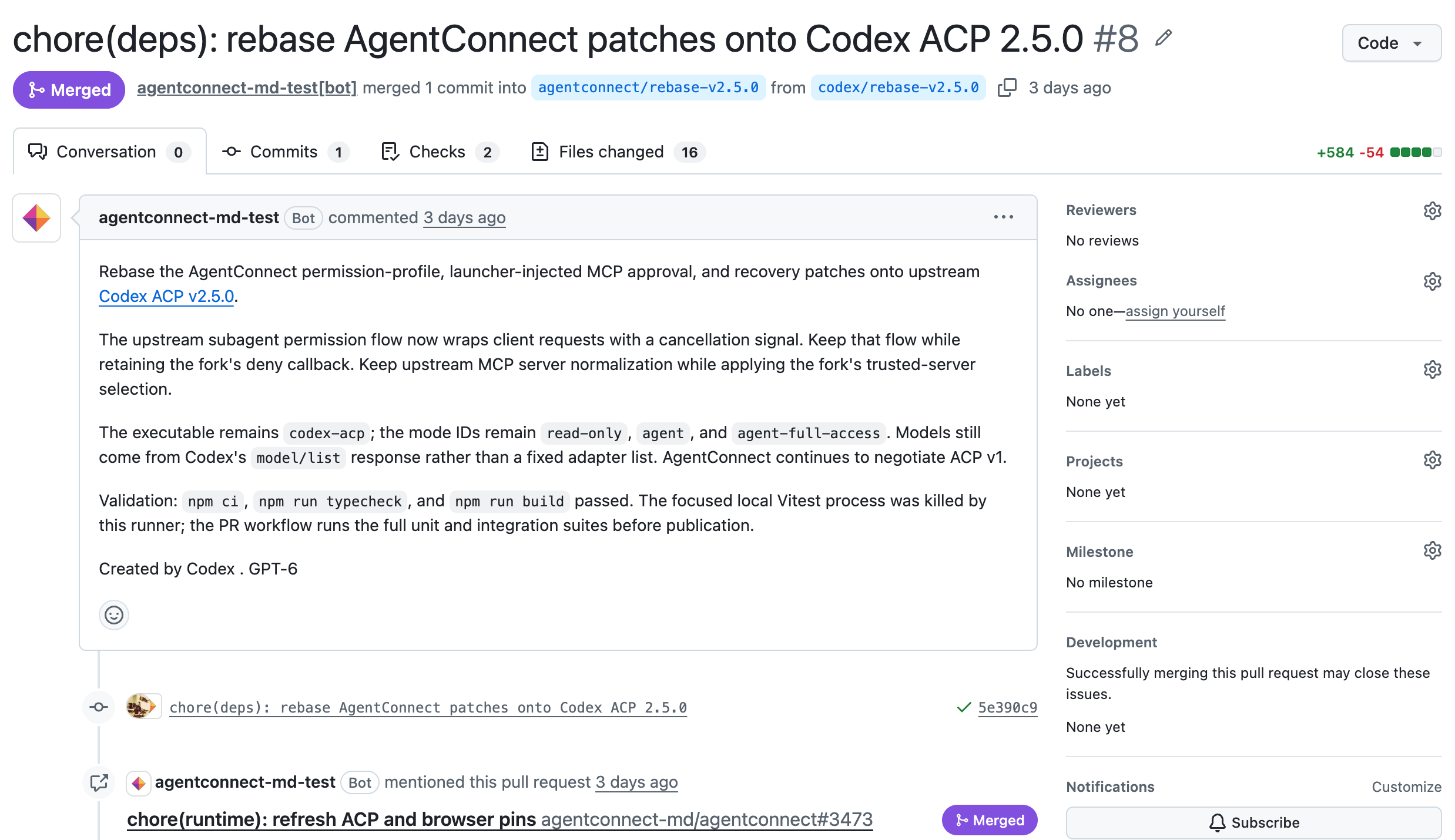
上游 fork。 我们维护一个上游 runtime adapter 的 fork,上游 tag 加一堆自己的 patches。patch 带逻辑,上游一重构,就不是解几行冲突,而是要看懂上游改了什么、我们的 patch 原本要干什么,在新版本上重新实现。这件事整个交给 coding agent:上游发版或定时任务启动它,它读两边的改动,判断哪些 patch 还要、哪些上游已经有了可以删、哪些要改写法,在自己的 worktree 里改好,跑类型检查、测试、构建,开 PR,把需要人判断的地方发到频道。那个仓库现在有 14 个 rebase 分支,一个上游版本一个,检查结果就在旁边。合并和发版是人做。
客户群客服。 一个支持 agent 在客户的 Telegram 群里答问题,答不了的升级到 Slack 的工程频道。群里 spam 多,每条消息先过一个评分,低于阈值的才给支持 agent,高于的给版主 agent。涉及具体账户的回复,人确认了再发。
generalist 能碰的仓库多,又同时接在公开频道、私密频道和私信上,权限问题绕不开。我们的做法是分三层。
agent 本身:谁能改它的配置,它能碰哪些仓库和工具,谁能在哪些频道用它,agent 之间谁能调用谁,各自单独设。
会话:谁能看一段会话,跟着这段对话所在地方的成员关系走。私密频道里的会话只有现在还在这个频道的人能读,退出频道就看不到;私信保持私密。不用另外维护一份名单。
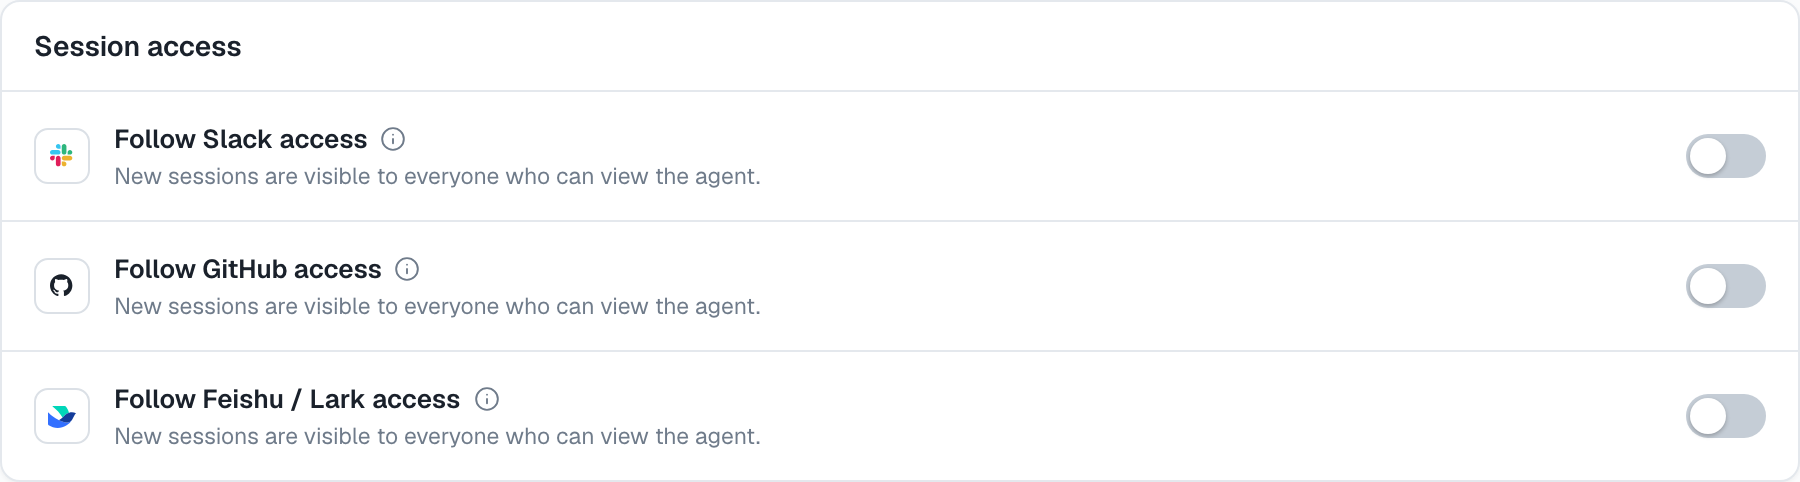
memory 按对话来源分层,在哪说的,就记在哪。公开频道里学到的进共享层,私密群和外部群的进那个群的层,私信里的进那个人的层;agent 回答时只加载当前对话有权读取的 memory。
需要人批准的操作,审批卡私信给这个 agent 的编辑者,不是频道里谁都能点。
context 放在哪
agent 的产出要留下来,团队和别的 agent 之后能查到;谁能看仍按来源控制。
设计文档和代码在同一个仓库的 docs/ 下,带实现状态,链到 issue 和 PR。项目说明文件写明文档在哪,改设计和改实现要在同一个 PR。产品仓库的设计文档从开源时的 35 篇到现在 100 篇。审 PR 的人直接读关联的设计文档,不用再开会让作者讲一遍。超出单个仓库的东西,运维手册、架构决策,进组织的知识库,所有者发布,带版本,agent 按需查。
怎么处理一类告警、怎么写 release 说明、怎么给 fork 做 rebase,每项一个 skill 文件,导入一次,按 agent 启用。有一次,每天核对价目表的 agent 发出报告后,一个同事在线程里问它是不是没找到对应的 skill。它确认没找到,之前是按频道里以往的做法做了一次只读比对。同事指出 skill 就在仓库里。它找到后确认,之前搜索时默认跳过了隐藏目录,并把这个问题记进了后续的工作约定。
agent 的 workspace 就是 Git 仓库,一个 agent 写的,别的 agent 下个会话就能读;同事自己机器上的 daemon 用的也是同一套仓库。Ticket 由干活的 agent 维护,有进展就更新,做完关掉,链到文档和 PR。
本地 Claude Code 和 Codex 的 memory 机制照用,只是把 memory 目录指到一个 Git 仓库,hook 在会话开始时拉、结束时推,换机器、换 harness 都是同一份。平台上 agent 的 memory 是另一套,按对话来源分层,前面讲过;两边以后考虑合并。
What's next
现在的 agent 都由 @、定时任务、PR 和 issue 事件、webhook,或者一个判断(这是不是 spam、该给哪个 agent)触发,做的是触发时指定的那件事。
主动型 agent。让 agent 更像一个 teammate,自己检查负责的事项,发现需要处理的问题时先提建议:比如发现一个刚合并的 PR 改了行为,对应的设计文档没跟着更新,它在开发频道里提出补一份文档 PR;或者客户群里同一个问题一周被问了三次,它提出把答案写进文档。人批准了才动手。已有预览版。
Computer use。有些事没有 API,只有桌面应用和浏览器。把一台电脑注册成一个 Computer,授权给指定的 agent,它们就能截屏、点击、输入;人在控制台看实时画面,随时可以接管操作。也是预览版。
进会议。现在会议是录完、转录、事后由文档 agent 处理。再往后,让 agent 作为参会者直接进会:会上可以问它,讨论定了的事当场写回设计文档和 issue,不用等会后。这个还没开始做。
AgentConnect 是开源的,Apache 2.0,Docker Compose 或 Kubernetes 都能部署。遇到问题欢迎提 issue,觉得有用也欢迎点个 star。